- 배경
대규모 신경망 모델의 지식을 작은 모델로 효과적으로 이전하는 방법에 대한 연구가 진행되고 있는데, 이는 모델의 효율성과 성능을 동시에 개선하는데 목적이 있다. - 문제점
기존의 Knowledge Distillation 방법은 단순한 Label 기반 학습에 의존해서 Soft Target 분포의 유연성과 정확도 사이에서 균형을 맞추는데 어려움이 있다. 복잡한 모델의 Probability Distribution 을 효과적으로 전달하는 방법이 부족하다. - 제안 기법
Temperature Scaling: Logit을 확률로 변환하는데 사용되는 온도 T 파라미터를 도입해서 경도를 조절한다.
Soft Target based learning:
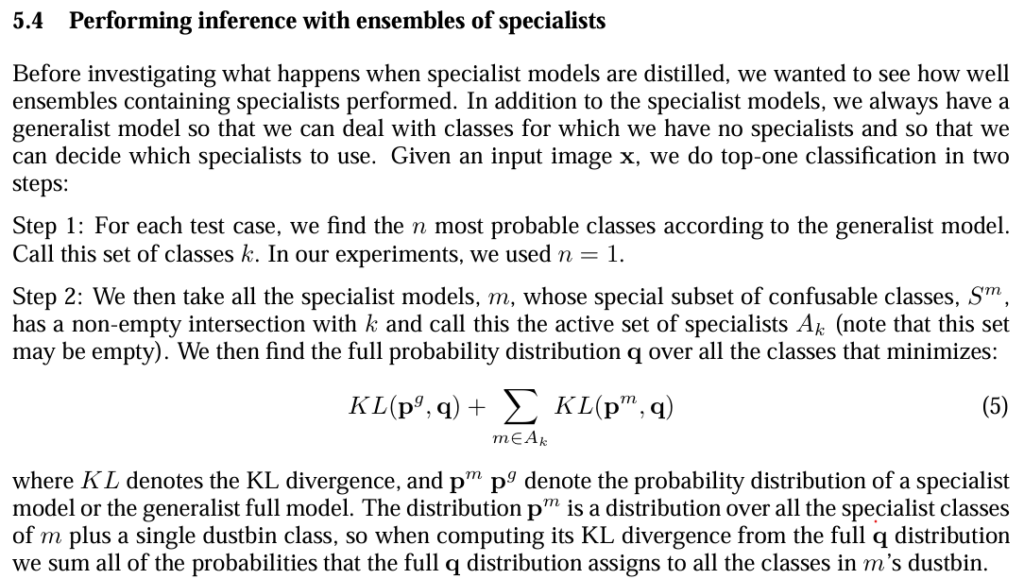
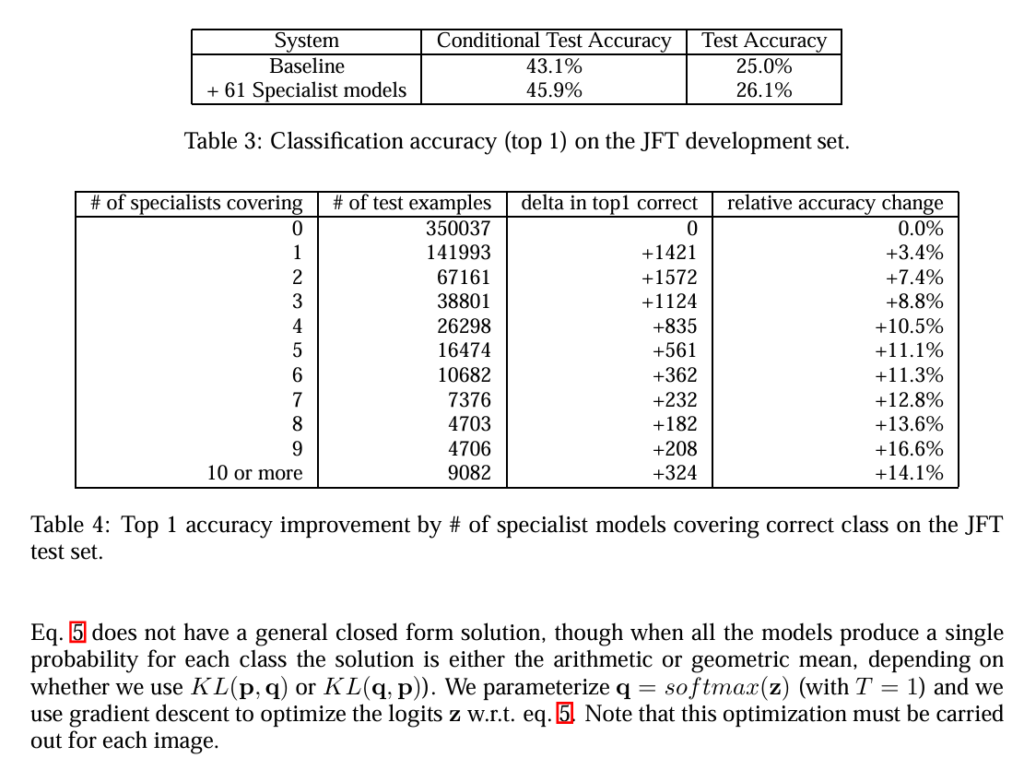
KL Divergence: - 실험 결과